给 AI 一条案情,让它引用法规判决。它会准确点出该引哪一条。但如果把那条法规换成无关的,它的判决往往一点不变。
一篇新公开的论文把这个假设拿来做反事实检验:固定案情,把模型被要求援引的法规或判例替换成一个无关项,再从各句边界的隐状态解码它判决的演化(来源:《被引用的法条未必被遵循》,Lexsi Labs,arXiv:2610.12361,2026-10,论文速递 2026-10-12)。
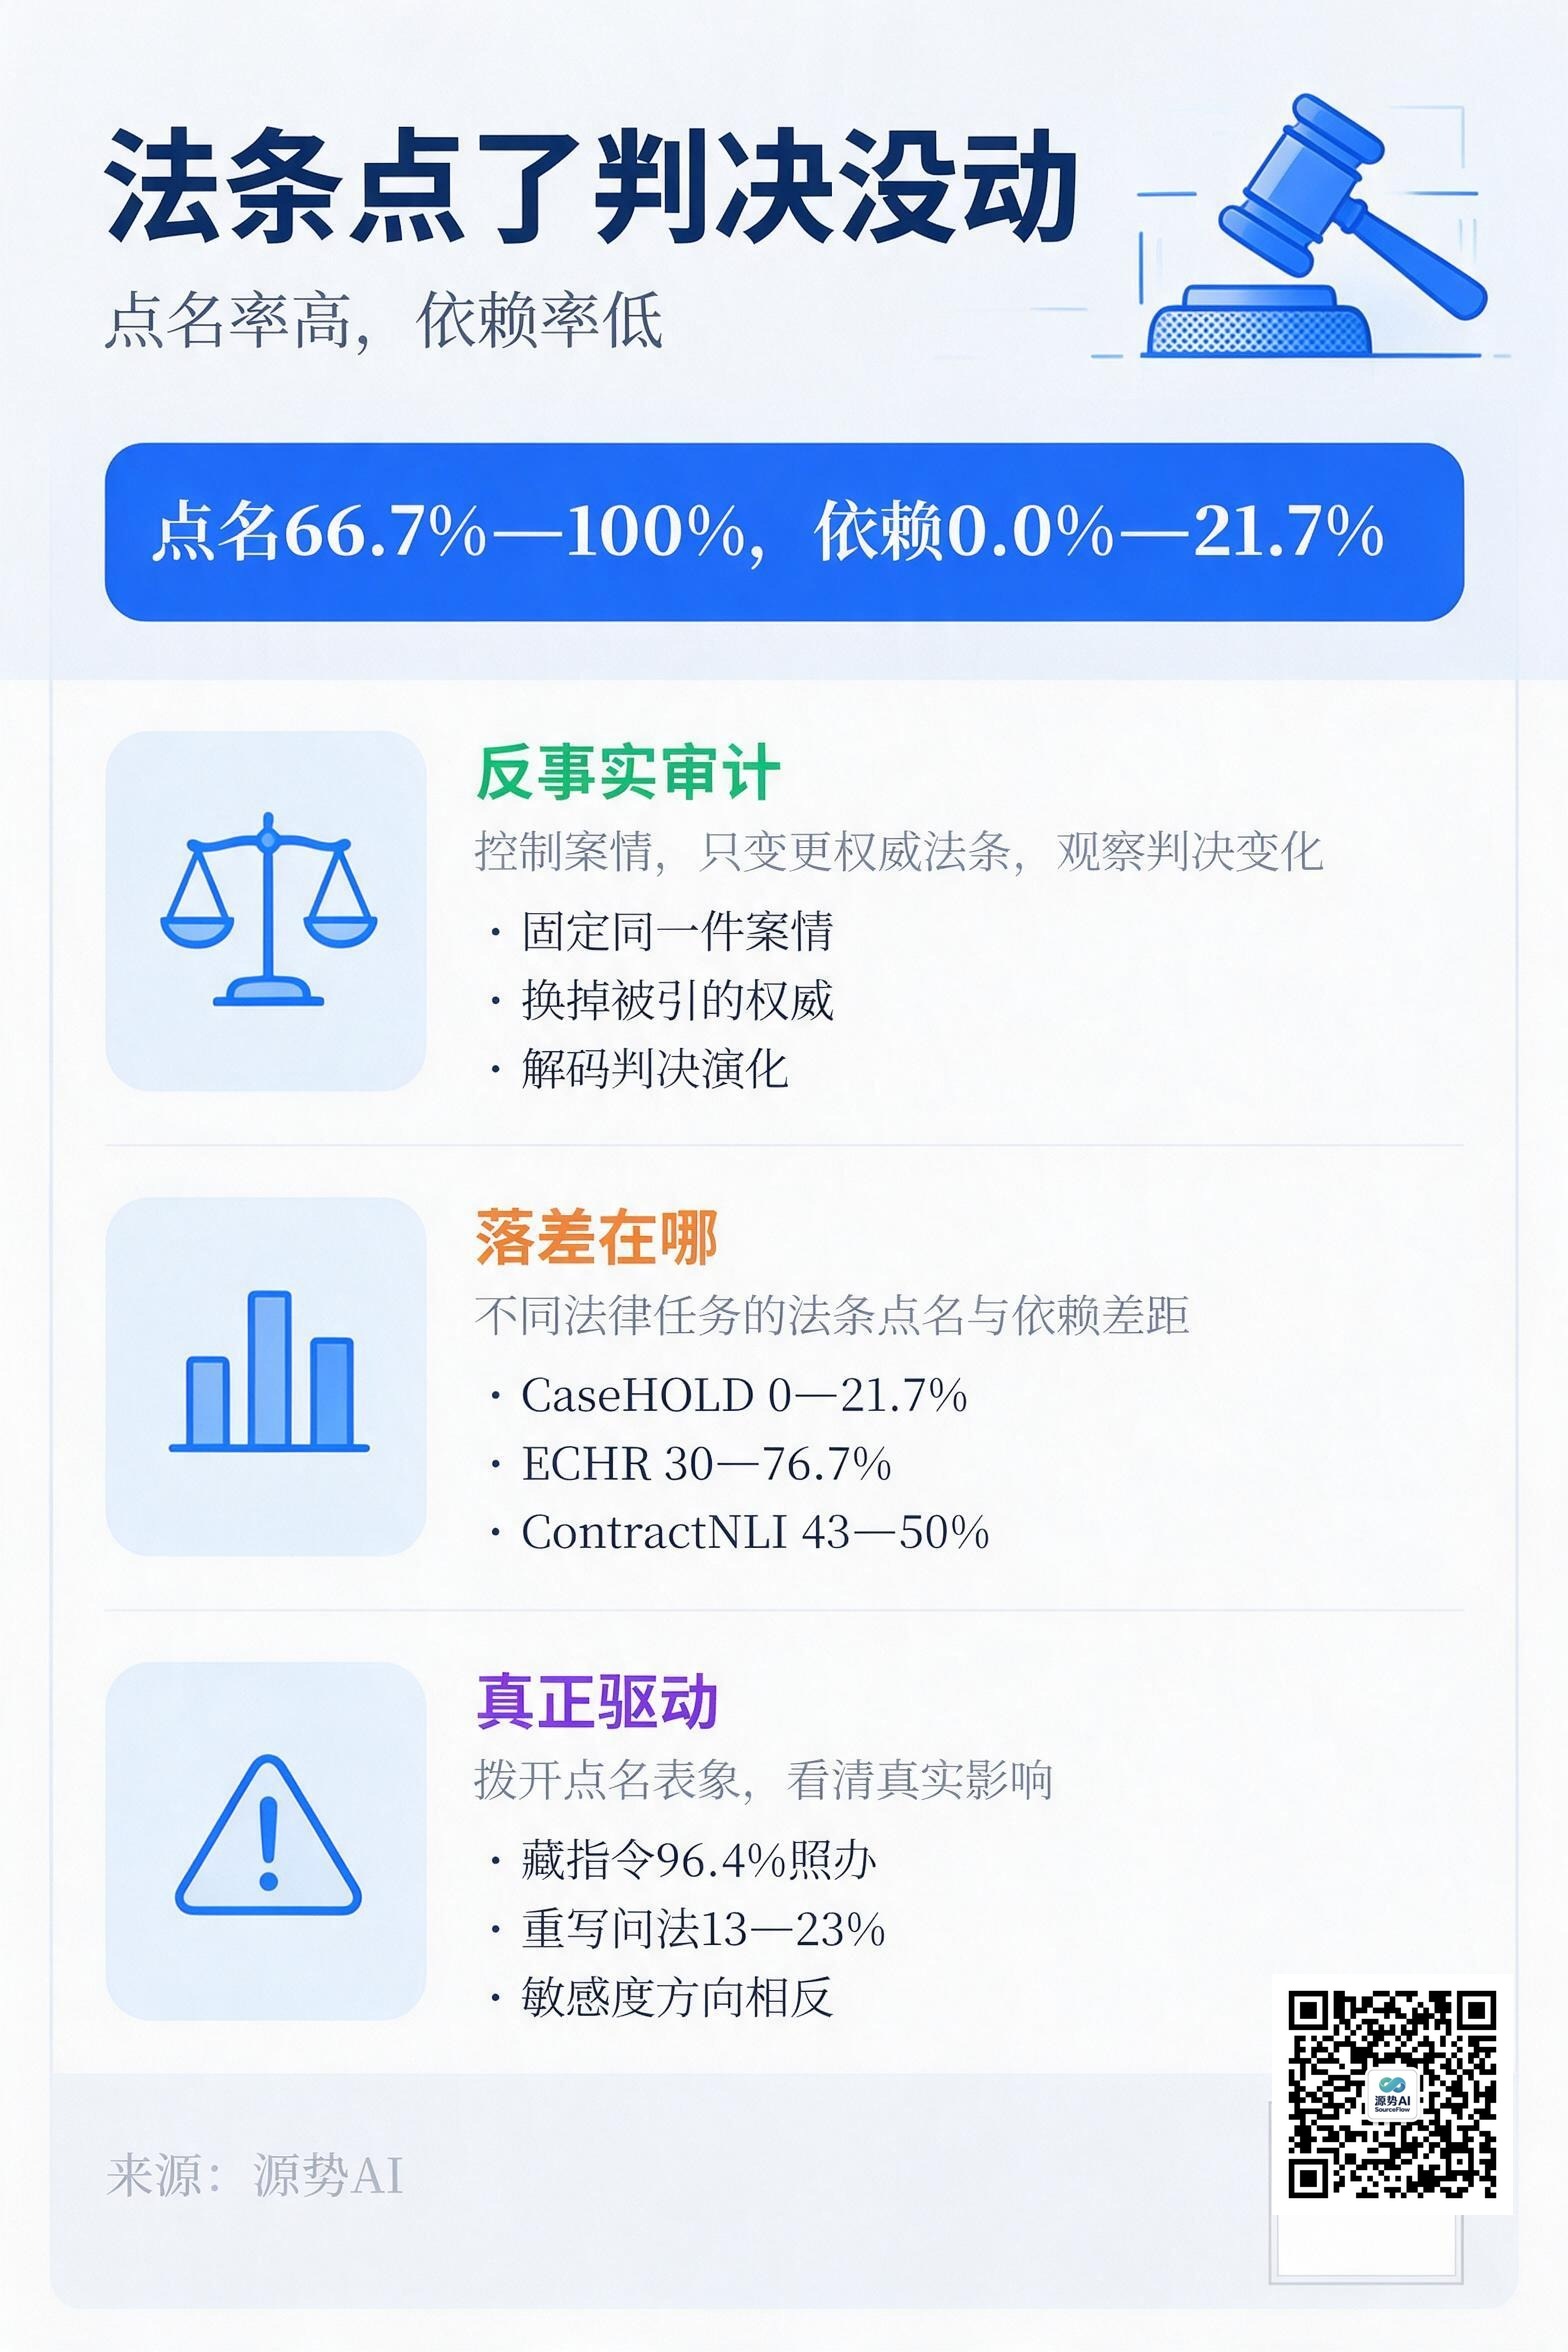
七个开源模型(8B 到 70B)与四个基准上,模型正确点名权威的比例为 66.7% 到 100%;而判决真的随权威替换而改变的比例,只有 0.0% 到 21.7%(来源:《被引用的法条未必被遵循》,Lexsi Labs,arXiv:2610.12361,2026-10)。
点名和依赖,是两件事
这组数字的差距,落在法律 AI 的核心假设上。
过去评测法律模型,常用的指标是"引用是否正确"——援引的法规是不是真的适用,判例是不是真的相关。这个指标隐含了一个假设:点名了权威,判决就依赖它。
反事实检验把这个假设拆开。结果是点名率高得稳定,依赖率低得不稳定:在 CaseHOLD 上是 0.0% 到 21.7%,在 ECHR、SCOTUS 上是 30.0% 到 76.7%,在 ContractNLI 上是 43.3% 到 50.0%(来源:《被引用的法条未必被遵循》,arXiv:2610.12361,2026-10)。把这些区间摆在一起,同一批模型在不同测试集上的差距很大,说明这不是"能力不够"的单一问题,而是判决到底依赖什么的问题。
论文还试了两个补救方向:把模型做大,或者专门做法务领域的 LoRA 微调。两者都补不上这个落差(来源:《被引用的法条未必被遵循》,arXiv:2610.12361,2026-10)。
还有一点要交代:这组数据的测试对象是 8B 到 70B 的开源模型,论文没有覆盖闭源大模型。但结论指向的问题与参数规模关系不大——引用是输出层的特征,依赖是推理过程里的特征,两者本来就可以分离。
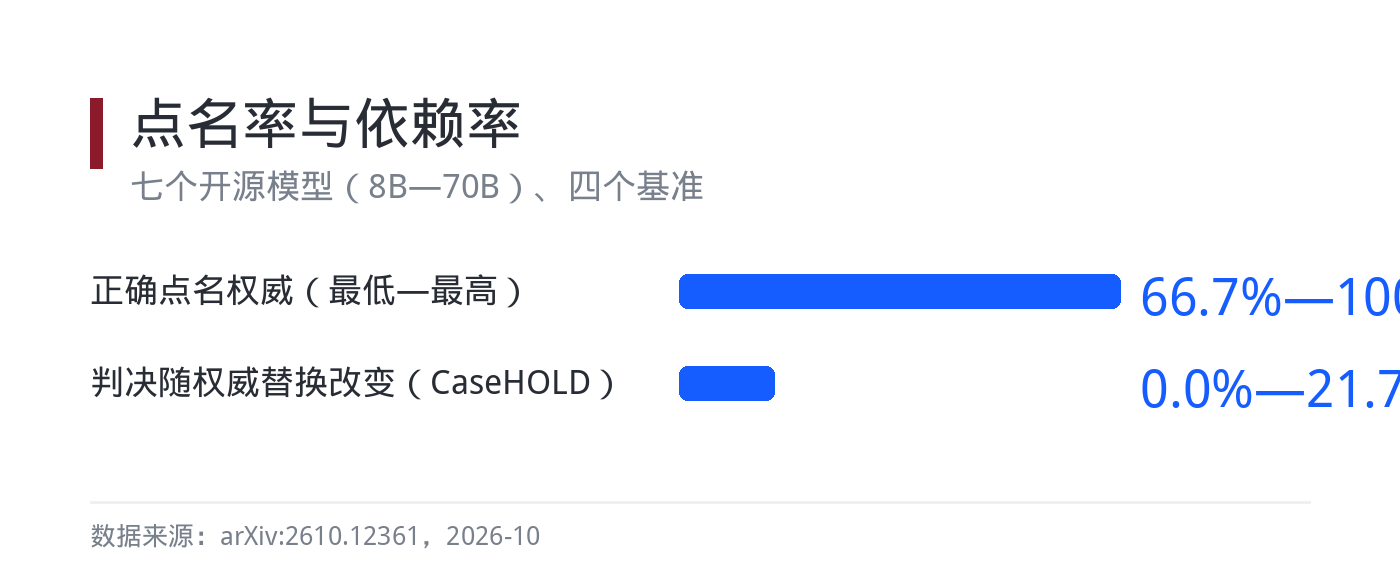
图注:七个开源模型正确点名权威 66.7%—100%,判决随权威替换而改变仅 0.0%—21.7%(CaseHOLD)(数据来源:《被引用的法条未必被遵循》,arXiv:2610.12361,2026-10)
真正左右判决的,是别的
如果判决不跟着法条走,那它跟着什么走?
论文的红队评估给了线索。把对抗指令藏进案情之后,73.3% 到 96.4% 的生成会照办;相比之下,重写问法造成的不稳定只有 13% 到 23%(来源:《被引用的法条未必被遵循》,arXiv:2610.12361,2026-10)。
换句话说,模型对"案子里塞进来的指令"高度敏感,对"法条被换成什么"却相当迟钝。敏感度的方向是反的:它对文本里最像指令的那部分反应最大,对应该决定结论的法律依据反应最小。
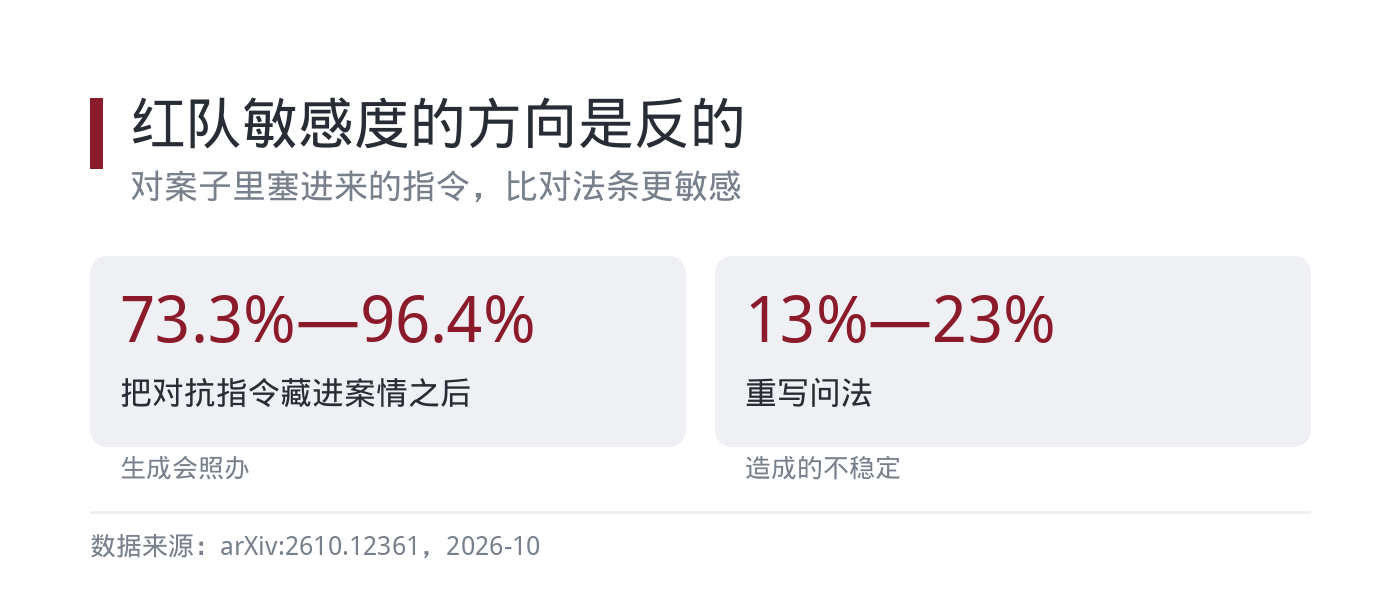
图注:对抗指令藏进案情后 73.3%—96.4% 的生成会照办,而重写问法只造成 13%—23% 的不稳定(数据来源:《被引用的法条未必被遵循》,arXiv:2610.12361,2026-10)
判决书不能当证据
这条结论对使用方意味着什么,论文说得直接:生成的"法律解释"既不能当合规证据,也不能当审计轨迹——两种用途被同时证伪(来源:《被引用的法条未必被遵循》,arXiv:2610.12361,2026-10)。
它把责任推回流程:如果要让 AI 参与法务判断,得有一套独立的验证环节。一段写得像模像样的法律分析,外部看起来完整、内部却可能没有依赖任何一条被引用的规范,这种输出比明显的错误更难拦。
对已经在用法务 AI 的团队来说,要改的是交付物定义:可以用它起草、可以用它检索,但每一句论断都要能追溯到一条被实际依赖的依据,而不是被引用的依据。这两者的差别,就是这份论文测出来的那段落差。
同一方向的研究今年有几条。牛津大学等团队构建了 LegalRewardBench,专门评测噪声检索与证据不足条件下的"接地生成",结论之一是模型应具备"证据不足时弃答"的能力;把长度平衡的法律偏好数据与通用上下文偏好数据混用,性能较基线提升最高 25.6 个百分点,且出现跨法域迁移——主要在维多利亚州刑法数据上精调的模型,在美国 Housing Statute QA 上提升 16.2 个百分点(来源:牛津大学、Devoteam《Building Legal Reward Models for Grounding and Abstention》,arXiv:2609.14739,论文速递 2026-09-19)。
另一篇针对金融监管合规问答的研究则指出,检索准确率的提升并不等于事实落地,两者之间存在落差(来源:arXiv:2609.30009《Automated Regulatory Compliance Question Answering in Financial Services with Domain-Adapted RAG》,论文速递 2026-09-26)。三篇论文指向同一件事:把"找到对的材料"和"结论真的建立在材料上"分开验收。
源势AI观点
第一,法律 AI 的验收指标要加一条"反事实测试"。只看引用是否正确不够,要固定案情、替换掉那条权威,看判决动不动。不动,就说明它只是把法条抄在了旁边。
第二,把"弃答"写进需求文档。证据不足时给出一个态度正确的答案,比拒答危险得多。LegalRewardBench 这类基准的存在,说明业界已经在把弃答当成一等能力,而不是缺点。
第三,合规场景里,AI 的输出只能进"草稿层"。合规证据与审计轨迹必须是可追溯、可复核的原始材料。我们给金融、能源客户做 Agent 落地时,把"AI 生成物不得直接作为对外证据"写成硬规则,就是这个原因。
话题标签:#法律AI #AI合规 #可追溯性